
当地时间8月25日,OpenAI正式对外公布首款自研AI推理芯片Jalapeño的完整性能实测数据。这款专为大语言模型推理打造的全新芯片,由OpenAI联合博通共同研发、依托台积电3nm工艺代工,从架构立项设计到最终流片落地,仅用时9个月,刷新了行业高端AI芯片的研发落地速度。
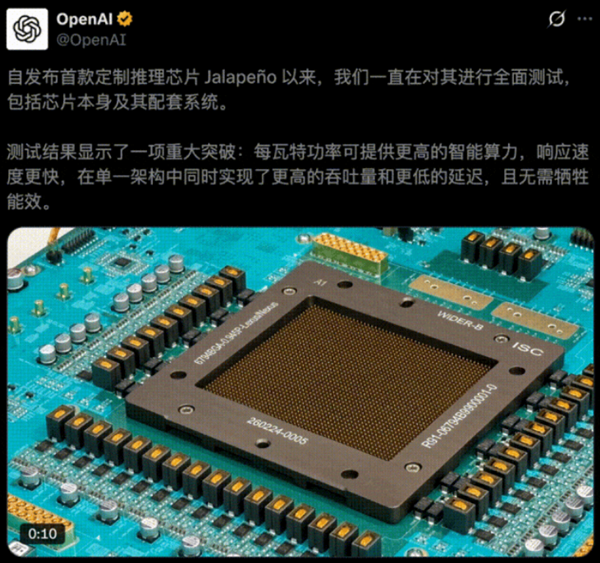
不同于通用型AI芯片,Jalapeño定位十分清晰,全程聚焦大语言模型推理场景,针对性解决大模型落地过程中高延迟、高功耗、算力浪费等行业痛点。极致的场景化定制设计,让这款芯片摆脱了通用芯片的性能冗余问题,能够更高效适配各类主流大模型的日常推理运行需求。
研发落地效率是这款芯片的一大亮点。业内常规高端AI芯片从设计、调试到流片量产,普遍需要一年半至两年周期,流程繁琐且投入成本极高。而OpenAI依托与博通的深度协同、台积电成熟先进的3nm制程能力,仅用9个月就完成全流程落地,展现出极强的技术整合与迭代能力。
此次公开的实测数据极具含金量。官方在GPT-OSS 120B、DeepSeek R1、Kimi K2.5 1T等多款主流大模型中完成对照测试,结果显示,Jalapeño能效表现大幅领跑行业标杆产品。芯片单位功耗的AI处理能力,达到市面主流高端芯片的1.5至1.9倍,同时端到端延迟大幅降低,最低仅为竞品的28%,实现了高吞吐、低时延、低功耗的三重突破。
长期以来,AI大模型算力高度依赖第三方通用芯片,推理成本高、算力适配度不足,始终是制约AI企业降本增效的核心难题。OpenAI自研推理芯片的落地,意味着其正式打破外部算力硬件依赖,补齐软硬件协同短板。通过芯片与大模型的深度适配,能够有效压低推理成本、提升用户交互响应速度。
Jalapeño的亮相,不仅是OpenAI补齐硬件版图的关键一步,也为AI企业自研专用芯片提供了全新范本。未来随着芯片规模化落地应用,将进一步优化大模型商业化成本,推动生成式AI产业走向更高效、更可控的发展阶段。
来源:光速网
内容说明:本文信息来源已在页面标注,仅供阅读参考。若涉及作品内容、版权或事实更正,请通过联系页面告知,我们将在核实后及时处理。